行业研究别再从零读起:实测Elicit,30篇论文变一张表
- 2026-11-10 13:13:38
📊 一张图看懂本文
行业研究别再从零读起:实测Elicit,30篇论文变一张表
今天有条新闻值得先看一眼。据雷峰网报道,全国首个具身仿真数采中心落地杭州,运营方影溯给出的目标很直接:全行业过去两年攒下的约 100 万小时 数据,它想用 1 个月 生产完。
这家企业做的是具身智能的数据供给——机器人要学会抓、放、拧、插,得先有海量「示范数据」。原来的路径是真机示教:一台机械臂、一个操作员、一个场景,反复演示几十遍,采一天下来只有几小时可用数据,场景覆盖还极窄。数据不够,模型泛化就上不去。
它落地 AI 的方式,从公开信息能看出三层。
第一层,不换模型,换生产方式。 把「真机示教」换成「仿真合成」——在虚拟环境里批量生成动作轨迹与视觉数据,再回真实场景做物理参数校准。真机负责对齐,仿真负责铺量。
第二层,不建项目,建中心。 数据采集不是给某一家机器人公司做一次性交付,而是把产能做成可复用的公共基础设施——一次投入,多场景、多客户分摊成本。
第三层,先解决量,再解决质。 先把长尾场景用规模铺满,再用真机数据对齐物理一致性,而不是一开始就死磕单条数据的高保真。
结果端按公开口径折算:行业平均积累速度约 100 万 ÷ 24 ≈ 4.2 万小时/月,目标产能 100 万小时/月,单位时间产出效率差约 24 倍;中心数量 1 个,定位是 全国首个;从立项到产出目标的时间线是 1 个月。
这 24 倍不是模型聪明了 24 倍,是生产方式变了 24 倍。
同样的账,办公室里也在算。知识工作里最没被「工业化」的一环,是读资料——找文献靠关键词试错,读摘要靠一页页翻,把样本量、方法、结论抄进 Excel 靠手,最后拼综述还得回头核一遍原文。一篇行业扫描 30 到 50 篇外文文献,2 到 3 个工作日就这么没了,抄错一个数字,后面全歪。
这期 AI 工具推荐只聊一个:把「读文献」这件事工业化的 Elicit。
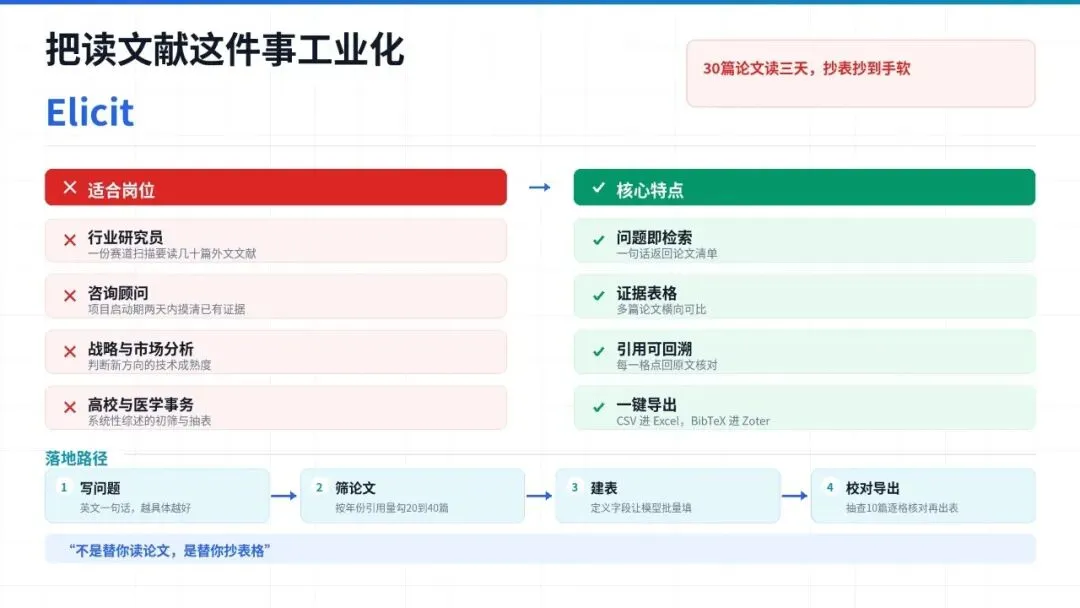
它适合谁:行业研究员、咨询顾问、战略分析
不是所有人都需要它。适配的岗位很具体:
• 行业研究员 / 市场分析师:一份赛道扫描要读几十篇外文文献,最后要出一张对照表 • 咨询顾问:项目启动期的证据汇总,需要在两天内知道「这个领域已经有人做过什么」 • 战略岗 / 产品规划:判断一个新方向的技术成熟度,先看论文怎么说 • 高校研究者、医学事务、政策研究:系统性综述的初筛与数据抽取环节
不适合的也直说:要查国内政策文件、券商研报、企业内部资料,它基本帮不上忙。
AI 辅助的文献证据整理,是指把「检索—筛选—结构化抽取—引用回溯」这条链路交给模型批量执行,人只保留判断和校对两个动作。Elicit 做的就是这件事,语料覆盖约 1.25 亿篇学术文献。
四个核心特点,每个都对着一个具体动作
另外它内置了系统性综述流程,筛选步骤可按 PRISMA 式记录,写方法学部分时有据可依。
五步操作流程
第一步,把问题写成一句话。 越具体越好,带上人群、场景、时间范围。建议用英文,中文提问也能跑,但命中率明显下降。
第二步,筛论文。 结果列表可按年份、引用量、是否同行评审过滤,勾 20 到 40 篇 加入工作区。这一步别贪多,30 篇是性价比最高的量级。
第三步,定义抽取字段。 除了默认列,可以自己加列,比如「数据来源」「是否随机对照」「主要局限」。字段定义得越清楚,抽取质量越高。
第四步,逐格校对。 这是唯一不能省的一步。抽查 10 篇,把每个数字点回原文核对。
第五步,导出成表。 CSV 进 Excel,或直接照着表格结构写综述框架——先有表,再动笔,写作顺序就顺了。
时间成本对比:17 小时 vs 90 分钟
以 30 篇外文文献、产出一张证据表加综述框架为例,传统方式拆解:
• 检索与筛选:2 小时 • 逐篇读摘要、记要点:6 小时 • 手工抄进 Excel:5 小时 • 拼综述框架:4 小时 • 合计约 17 小时,摊到 2 到 3 个工作日
用 Elicit:
• 提问与检索:10 分钟 • 筛选论文:20 分钟 • 自动抽表:15 分钟 • 抽查校对 10 篇:40 分钟 • 导出整理:5 分钟 • 合计约 90 分钟
净省约 15 小时。但要说清楚:省下的是「抄」和「找」的时间,不是「想」的时间。校对那 40 分钟省掉,整张表就不能用。
一个实用的 AI 应用技巧是反过来用——先让 AI 把表建出来,再带着表去读论文,读的时候只补表里空着的格子,注意力会集中很多。
横向对比:它和三款常见工具差在哪
Consensus:一问一答式,问「X 对 Y 有效吗」直接给结论和证据强度,适合快速确认某个说法有没有支撑。年付折合约 9 美元/月,比 Elicit 便宜。但它不做多篇论文的结构化表格,20 篇横向对比还得自己抄。
Semantic Scholar:免费,检索质量和引用网络很强,找种子论文效率高。但它只负责「找到」,不负责「抽出来」,表格环节依然靠手。
ChatGPT / Gemini 的深度研究功能:能直接出长报告,行文流畅,适合快速摸清一个陌生领域。问题是引用要逐条核,而且产出是段落不是表格,多篇之间不可横向比对。这类通用智能体工具做「概览」很好,做「证据汇总」不合适。
Elicit:目前少见的把「多篇论文压成一张可比表」做顺的产品。基本档免费但有月度额度,Plus 档官网标注约 12 美元/月,Pro 档约 49 美元/月(以官网为准)。它不是一个浏览器 AI 插件,而是独立的证据工作台,得单独打开用。
和那些 AI 创作工具比,它更像一把镊子——不产出漂亮内容,只负责把散在各处的证据夹到一张纸上。把它嵌进文献综述的 AI 工作流里,位置在「检索之后、写作之前」。
实测的正反面
值得夸的: 表格抽取省下来的不是阅读时间,是抄写时间,而这恰恰是综述里最没有智力含量、又最容易出错的部分;引用可回溯这一点很关键,它让「AI 整理的东西能不能用」变成一个可以验证的问题,而不是靠信任。
要骂的也很具体:
• 抽取会出错行、漏抽。 论文里表格复杂、跨页排版时,串行和漏项都出现过,中文文献的错误率更高 • 中文材料覆盖差。 中文期刊、券商研报、政策文件几乎搜不到,做国内市场研究只能用一半 • 界面全英文。 功能不难,但对英文不熟的人有上手门槛 • 免费额度不经用。 认真跑两个课题就见底,最后基本都会付费 • 它不替你做研究设计。 复杂的因果问题,它给的仍然是一份论文清单,怎么设变量、怎么排除混杂,还得自己想
Elicit 不是替你读论文,是替你抄表格——把 30 篇文献压成一张可比对的证据表,判断和结论仍然得自己下。
FAQ
Q1:Elicit 能搜中文论文和国内的行业报告吗?
基本不能。它的语料来自 Semantic Scholar,以英文期刊和预印本为主,中文期刊、券商研报、政策文件几乎检索不到。做国内市场研究,它只能解决「国际文献」这一段,国内材料还得另找渠道。
Q2:免费版够用吗,值不值得付费?
轻度试用够,正式做课题不够。免费档有月度额度,勾 30 篇论文加多列抽取,两三个研究问题就见底。真要跑完整综述,Plus 档约 12 美元/月更现实,折合人民币不到一百块,成本基本等于省下的两小时人工。
Q3:它抽出来的表格数据能直接用吗?
不能直接用,必须校对。实测中会出现错行、漏抽,复杂表格尤其明显。可执行的做法是固定抽查 10 篇,逐格点回原文比对,把错误率压到可接受范围再用。直接拿导出结果写结论,风险很高。
本文为 AI 工具实测系列第 N 期。文中数据来源:雷峰网《全行业两年攒下百万小时数据,影溯想 1 个月生产完》(https://www.leiphone.com/category/academic/xPVWQgBN3Foj7fo5.html);Elicit 产品信息与定价引自官网公开页面。
延伸阅读:本期内容已收录进「」AI 工具实测库,如需系统梳理岗位级 AI 工作流,可在文末留言获取本期知识结构图。
🏕️ 之江商学AI增长营 · 企业AI实战落地
3天封闭式实战集训营:不讲课、不空谈,带着企业真实业务问题来,3天后带着落地方案走。
Day1 认知与战略——先想明白,再动手
• 查四维:从战略、业务、组织、数据四个维度,给企业AI现状做一次全面体检 • 测十倍:评估哪些业务环节用AI能带来十倍级效率提升 • 定战场:锁定最值得率先突破的1-2个AI落地场景
Day2 场景共创——把方案做出来
• 找三多:找到重复多、规则多、数据多的环节(AI最擅长的地方) • 过三关:用成本关、数据关、组织关,筛掉伪场景、留下真战场 • 排三战:排出速赢战、攻坚战、持久战,明确推进顺序
Day3 能力实操——十大部门现场演练
• 销售、财务、HR、运营、生产等十大部门分组,用真实业务数据实操AI工具 • 每组产出可落地的AI应用方案,现场路演验收,导师逐一点评
学完带走:企业AI落地路线图 + 优先场景清单 + 各部门可执行方案
适合人群:企业主、高管、HRD、培训负责人