永鑫行研 | AI 芯片技术路线行业研究(下)
- 2026-11-10 21:25:29
本文是永鑫方舟团队第96篇原创行研
说明:本文涉及国内未上市企业的技术路线、产品节奏与经营口径,除特别注明外均来自公开披露与永鑫的走访整理,相关参数以量级表述,具体规格以企业正式发布为准。本文不构成投资建议。
前言
上篇拆开的是硬件本身:计算架构、数据距离与集成方式(永鑫行研 | AI 芯片技术路线行业研究(上))。但技术路线从不单独成立——它要落到具体场景,要面对供给与成本的约束,还要回答一个问题:这条路线在什么时间、以多大体量变成收入。
本篇先补齐技术侧的最后两节:AF 分离(Attention–FFN Disaggregation)——把同一个 Transformer 层的注意力与前馈网络拆到不同硬件上执行;以及集成方式创新(芯粒与先进封装)。随后是场景适配与关键指标体系,回答“哪些路线适合云侧、哪些适合端侧、哪些适合训练、哪些只适合推理”。
市场部分按四步展开:需求驱动、供给端的三重约束(制程、存储、封装)、空间测算(云侧与端侧分开算,公式全部写明),以及全球与国内的竞争格局。国内一侧,我们把十六个标的按“计算离存储阵列有多近”重新排了一遍,并给出商业化进度的时间轴。
需要说明的是,行业数据在不同机构之间分歧很大。本文对所有关键数字都标注口径与来源,冲突处并列保留、不强行取舍;所有测算均给出公式,可复算。
AF 分离(Attention–FFN Disaggregation)指的是把同一个 Transformer 层里的两类子运算拆到不同硬件上执行:注意力子层(Self-Attention,连同它读写的 KV Cache)留在通用 GPGPU 或高带宽近存芯片上;前馈网络(FFN)与混合专家(MoE)子层搬到大容量、以只读权重为主的专用加速器上。名称直接取自两类模块的首字母——A 为 Attention,F 为 FFN/MoE。它不改芯片内部结构,也不改存储器件,改的是“哪一段运算跑在哪台机器上”,因此属于系统层面的组织创新,与本文前述三条路线分属不同维度。Y**2的具体落法是:A 侧用 2.5D HBM 加 3D SRAM 的 APU,F 侧用 3D NAND 存算的 EPU,二者以 AF 分离软件栈调度。
它常被与 PD 分离混为一谈,两者切的其实是不同维度。PD 分离(Prefill–Decode Disaggregation)按推理阶段切,是时间轴上的分工,解决“同一批硬件在两个阶段的负载差异过大”;AF 分离按算子类型切,是数据流图上的分工,解决“同一阶段内不同算子的资源画像相反”。二者正交、可以叠加:Y**2的方案在 AF 分离的同时明确兼容 PD 分离,先按阶段排产、再按算子分机。也正因为它既不属“改计算架构”、也不属“改数据距离”,本文把它单列为并列于三条硬件路线之外的横切主线:系统组织——三条路线改硬件本身,它改“哪段运算跑在哪台机器上”,两者可叠加而不互相替
代。
还有三个近邻概念需要与之区分,否则容易把不同做法都叫成“分离”。专家卸载(Expert Offloading)把专家权重放在处理器内存或固态硬盘上、用时再搬进显存——它发生在同一台机器内部,是按需搬运,本质是分层存储,计算仍由同一颗图形处理器完成;AF 分离则是把计算本身挪走。KV Cache 卸载只解决显存容量不足,把历史键值搬到低速介质,既不改变算力归属,也不解决专家权重的分布式存放问题。投机解码(Speculative Decoding)用一个小模型先草拟若干 token、再由大模型校验,属算法层加速,与硬件分工无关。三者的共同点是“看起来都在省显存”,区别在于省下来之后,计算到底在哪里发生。
这条路线直到 2026 年才具备可行性,是三个条件同时到位的结果:MoE 成为主流架构,专家权重占到 95% 且推理时只读,才有“把专家池单独放”的经济价值;闪存带宽与混合键合工艺把只读权重层的带宽抬到可用量级;推理取代训练成为主要负载,成本而非峰值算力成为竞争焦点(资料来源:永鑫整理)。
分离能否成立,取决于两类模块的显存使用特征是否真的相反。按Y**2对 DeepSeek、智谱、千问、Kimi 这一代模型的拆解:注意力模块权重占比约 5%,但每轮对话都要写入新生成的 KV Cache 并读出历史部分,属频繁读写;混合专家模块占 95% 的权重,推理时只读不写——输入一个 token 激活若干专家,用专家权重做矩阵乘取出知识,再吐出一个 token,过程无状态。行业要支持百万级上下文,KV Cache 只会继续膨胀,两者的分化还会加剧。
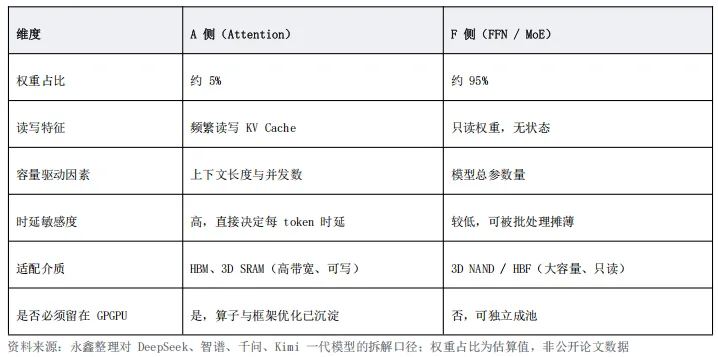
分离为什么必要,根子在同构方案的死结。一颗 GPGPU 以 2.5D 封装 6 至 8 颗 HBM,D300 级别总容量约 288 GB;因为两类模块没有分离,显存只能一半放 KV Cache、一半放权重。更麻烦的是专家是分布式的:每个用户实时激活哪几个专家无法预知,专家权重又分散在多颗 GPGPU 上,命中别卡的专家就要把 token 发过去,形成乱序的全互联通信;并发开得越高、权重分布越散,这项开销上升越快,最终可能超过本地计算与存储的开销。单颗 GPGPU 成本约有一半花在 HBM 与封装上,而这些 HBM 在推理时并未被高效利用——这是“堆 HBM 降不了本”的根因。
这条思路不是一家之见。把全球已有产品布局按“A 侧用什么、F 侧用什么”排一遍,异构分离已是头部厂商的共同方向:英伟达用 GPGPU 配 HBM 承接注意力,把解码侧交给授权而来的 Groq LPU(依赖片上 SRAM);OpenAI 的 XPU 配 HBM4,对接 Cerebras 的晶圆级引擎;AMD 的 GPU 配 HBM,对接 Tenstorrent 的专用 ASIC;国内亦有“国产 GPGPU 配 HBM2e 做预填充、海外 GPU 配 HBM3e 做解码”的组合。差别只在各家把分界线画在哪里——切在阶段上(预填充与解码)、切在算子上(注意力与专家),还是两者都切。
AF 分离按拆分发生在哪一层,有三种实现形态,代价与收益依次递减。第一种是跨机分离,把 A 与 F 放进不同机柜、以 RDMA 互联——Y**2走这条,硬件配置最灵活(GPU 与 EPU 可按比例各自扩容),代价是每一层都要在两侧往返一次 token,跨机柜延迟为个位数微秒。第二种是同封装分离,把两类介质的 die 与计算 die 叠进同一颗芯片——J***走这条,NAND 承 FFN、DRAM 承 Attention,省掉了跨机往返,代价是把 A 与 F 的容量比例在硬件上绑死,并额外面对 3D 堆叠的散热约束。第三种是只换介质不拆硬件,F 侧的存储层从 HBM 换成 HBF、算力仍留在原芯片——L*走这条,改造量最小、收益也最小,可视作 AF 分离的最小可行子集。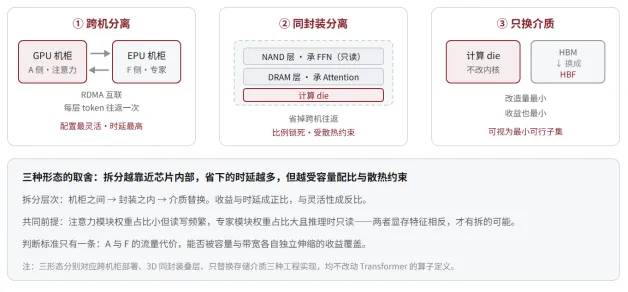
图 6:AF 分离的三种实现形态——拆分发生在哪一层,决定了时延与灵活性的取舍 资料来源:永鑫整理
落地证据目前停在系统级而非芯片级。Y**2用市售配件搭出全闪型一体机,以 PCIe 5.0 SSD 替代 DDR5,已实现加速器与闪存存储层之间的 AF 分离部署,实测 DeepSeek V4 Flash、V4 Pro 与 Kimi K3 三类旗舰模型均达 20 token/s 以上,并称整机降本三成以上;自研 EPU 芯片计划 2027 年上半年流片(一体机数据为公司自测,芯片尚未流片)。
这套方案的工程取舍同样值得记录:只堆两层、单颗算力只放到数十 TOPS,理由是散热——3D 堆叠越厚、算力越密,热密度越难处理;换来的是机柜可用风冷,客户不必改造机房。读延迟是 3D NAND 的固有代价,从 HBM 的 10 至 100 纳秒升到个位数微秒,但只在首次读出现一次,确定起始地址后连续读不再有这一延迟,可被系统方案隐藏;写延迟更大,因此明确不做 KV Cache,只存权重。制程上这一代用成熟工艺(产能充裕、成熟度高),下一代规划 12 纳米。
最容易被质疑的写入寿命问题,公司的回答分三层:普通 PCIe 闪存(TLC/QLC)全盘擦写约 1 万次,而 HBF 用单层单元(SLC),可擦写次数约 10 万次;写入只在模型更新时发生,据其了解,生产环境的模型更新以月为单位,即便按一天一次计算,十年约 3,000 次,仍远低于寿命上限;公司明确不服务“模型厂每天迭代权重”的场景,只承接已发布、上线到生产环境的模型版本(最频繁一周一次)。需要提示的是,头部云厂商与大模型公司真实的擦写频率,公司并无直接数据,仅与少数客户沟通过,这一项仍待核实。
方案的适用边界也很清楚。AF 分离后每一层都要在 A 与 F 之间往返一次 token,跨机柜 RDMA 延迟为个位数微秒;在 50 至 100 TPS(上限 200 TPS)的目标下,这部分约占推理总时延的 10%,不成瓶颈。反过来看,追求上千 TPS 的 GPGPU 加 LPU 方案,同样的微秒级延迟在更短的时间窗里占比会升到几十个百分点,做不了分离——这解释了为什么分离式架构与极致速度路线天然互斥。并发基线方面,当前推理节点普遍设计在 128 至 512 并发,Y**2按这一区间设计;要走到千级并发,取决于超节点规模与跨机柜带宽能否在两三年内跟上。
供应链是这条路线最大的外部依赖。HBF 颗粒与混合键合封测目前均依赖国内一家 3D NAND 原厂——公司取的是其 2-Hi 堆叠的裸颗粒,再与自研基础 die 叠合,因此绕开了标准 HBF Cube 必须走 2.5D 中介层、基础 die 需先进工艺的路径。据公司口径,该原厂没有余力支持大量定制,能拿到定制颗粒的客户极少;堆叠良率与原厂工艺成熟度合计“认为”可超过九成——但这是推算而非实测。备选方案上,闪迪与 SK 海力士的 HBF 可通过韩国渠道取得,但管控严格。合规方面,公司称设计规格严格卡在出口管制阈值内,单颗面积与算力均未越线。
对这条路线最有力的反问是:若 HBF 直接放到硅中介层上、紧挨 GPGPU,比跨机柜方案更近更快,是否就不需要分离?公司的回答有三层——把 NPU 贴到 GPGPU 旁仍要面对全互联通信,因为权重依旧分布式存放;HBM 装不下全部专家,缺专家时要从 HBF 搬到 HBM,搬运代价大;更重要的是把 A 与 F 的容量比例在硬件上绑死,而未来模型做到 5T、10T 时专家数如何变化并不确定。因此宁可牺牲一点时延换灵活性,做成集中的“专家池”按需配比。这一判断与前述分离逻辑一致:分离的收益不在速度,而在让容量与带宽各自独立伸缩。
时间表上,全闪一体机是过渡产品:整机成本在数十万元量级、可跑 T 级总参模型,但同时只服务个位数用户——单块 SSD 带宽不足以支撑数百并发,这正是必须自研 HBF 芯片的原因。自研 EPU 的节奏为 2027 年上半年流片、同年回片交原厂合封、2027 年四季度在自有服务器上测试、2028 年一季度量产;下一代 EPU 规划 12 纳米,注意力侧的 APU 与智能体场景的 XPU 分别排在 2028 年与视市场反馈再定。
1.8 技术路线三:集成方式创新
三条硬件路线中的第三条,既不改计算也不改存储,而是改“一颗芯片”的定义。当单die 面积逼近光罩极限(约 33 mm × 26 mm)、良率随面积指数下滑时,把大芯片拆成多颗小芯片、再用先进封装拼回去,成为延续性能提升的现实路径。
芯粒(Chiplet)的价值有四层:良率(小die 良率高,且可分级筛选)、异构(逻辑用先进制程、模拟与 I/O 用成熟制程)、复用(同一颗 I/O 芯粒服务多条产品线)、周期(迭代只改一颗芯粒)。国内代表企业B***把这一思路概括为“通用 HUB 芯粒 + 专用功能芯粒”:HUB 承载 CPU、I/O 与高价值通用 IP,功能芯粒承载 GPU、NPU、座舱娱乐等差异化模块,两者通过自研的 PB Link 互联。
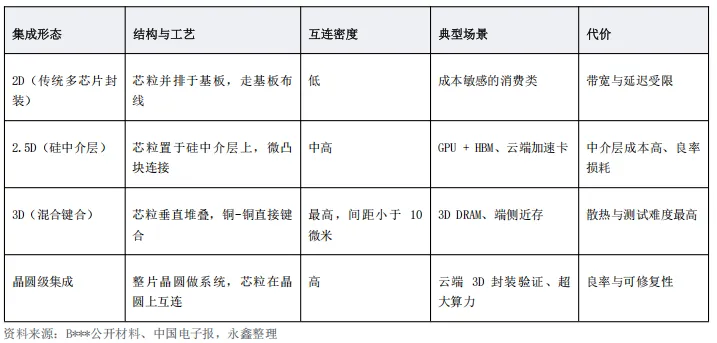
标准是这条路线能否规模化的关键。国际侧,UCIe 2.0 于 2024 年底发布,是业界首个“3D 原生”互连协议,带宽密度从 1.0 版的约 2 TB/s/mm 提升至约 4 TB/s/mm,能效从 0.5 pJ/bit 降至 0.25 pJ/bit 以下。国内侧,中国 Chiplet 产业联盟于 2023 年 2 月发布《高速芯粒互联标准》,B***的 PB Link 是首个实现商业化的国产接口:面积 3.6 mm²、8 通道单向 256 Gb/s、双向 512 Gb/s、端到端纳秒级时延、误码率优于 10⁻¹⁵,并支持 ASIL-D 功能安全。
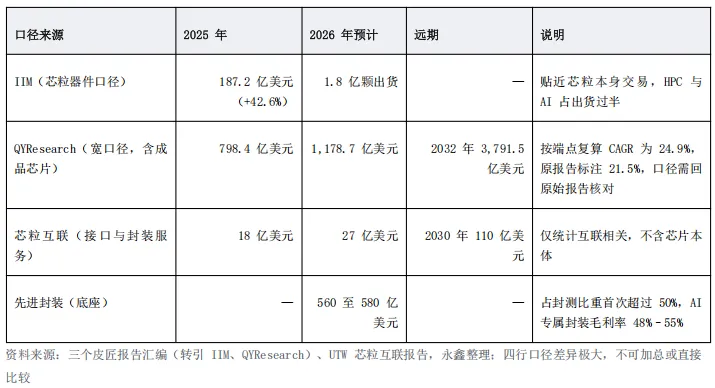
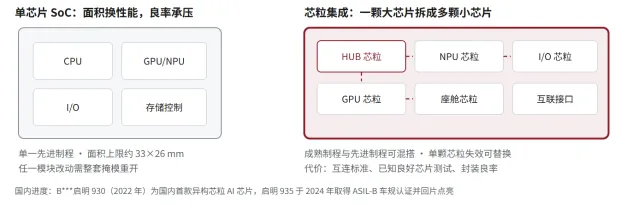
图 7:单芯片 SoC 与芯粒异构集成的结构差异 资料来源:B***公开材料、永鑫整理
1.9 场景适配:哪些路线适合云侧、端侧、训练与推理
技术路线没有优劣,只有与负载的匹配。把“训练/推理”与“云侧/端侧”交叉,可以得到六个真实存在的产品位。判断一颗芯片是否站得住,只需要问三个问题:它的负载是计算密集还是访存密集,它的功耗预算是多少瓦,它的容量能否装下模型。
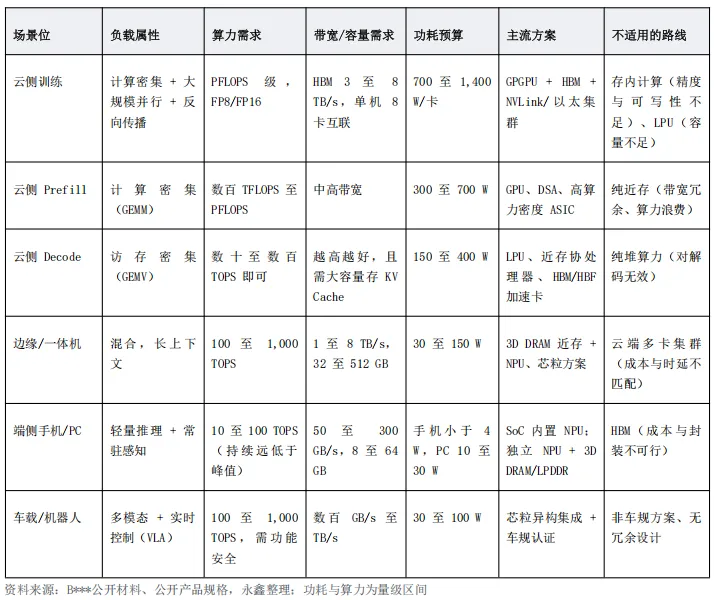
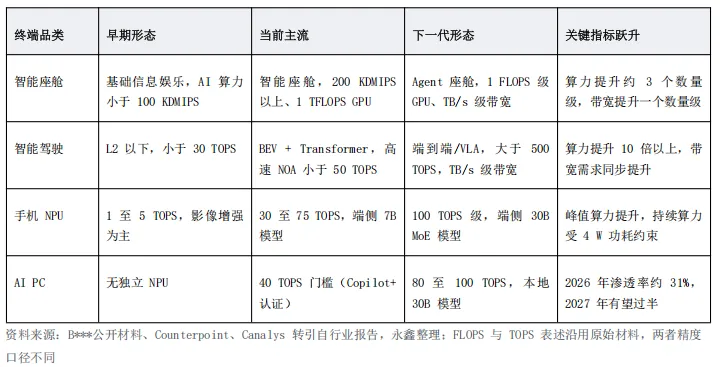
端侧的算力分层比云端更精细,因为每一档都由模型规模倒推。行业通行的对应关系如下:10 亿参数以下用于可穿戴与物联网的语音唤醒;10 亿至 90 亿参数对应手机与家庭中枢的摘要、翻译与视觉理解;70 亿至 300 亿参数对应 AI PC 与普通一体机的本地知识库与办公;300 亿至 2,000 亿参数需大内存一体机承载。这也解释了为什么“独立 NPU + 大容量近存”首先在手机与 PC 上出现——它们恰好卡在模型规模跃升的临界点上。
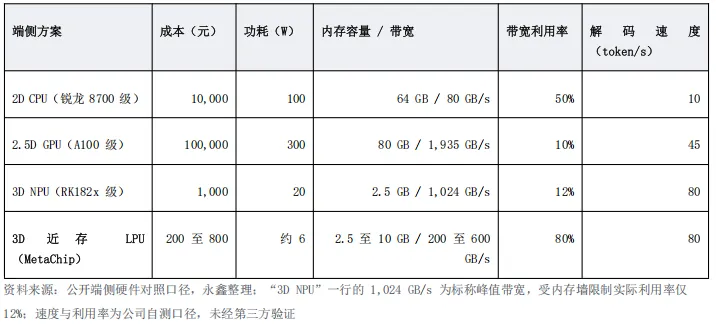
端侧还有一个被忽视的事实:标称带宽不等于可用带宽。行业公开的对照测算把端侧四类硬件放在同一张表里,结论是带宽利用率而非峰值决定了实际解码速度——3D NPU 的标称带宽高于 3D 近存 LPU,但利用率只有 12%,实际速度并未拉开,成本却高出数倍。
这一支的产品化节奏已具体到型号与价格带。M**的 MC-Mega 系列按模型规模切三档:覆盖 2B 至 9B 模型,算力从数 TOPS 到十数 TOPS、功耗 2 至 8 瓦、内存 2.5 至 20 GB、带宽 200 至 600 GB/s,售价自百元级递进到千元以内;三档均标称数十 token/s 以上,分别排 2026 年二至四季度上市;芯片以国产成熟工艺集成 2.5 至 20 GB 的 3D DRAM,已完成首次流片。另有面向边缘的 3D-FLASH 卡,覆盖 35B 与 120B 级 MoE 模型,容量数十 GB、算力数十至近百 TOPS、功耗 40 至 80 瓦,售价在数十至百美元级(价格与出货量为公司规划,需以实际量产为准)。
需提示口径差异:600 GB/s 的目标带宽高于上表所给端侧主流区间(50 至 300 GB/s),属“把端侧推到 PC 级”的进取假设;上述速度为公司设计目标而非第三方实测,200 至 800 元的售价对应芯片而非整机。
产品形态上还出现了两个新品类。一是“智能体计算机”(Agent Computer):桌面小型方盒,面向个人或小团队提供本地知识问答、代码辅助与内容处理,公司称已在联想 AI 主机 P7、明略 Mano 等项目中获得定点。二是边缘侧的“三合一”替代——把全光组网终端、网络视频录像机与 AI 算力盒合并为一台 AI 网关,H***的 Lite2/Pro/Pro Max 系列合计中标 13.2 万台;其 M50 加速卡单卡功耗 10 瓦,对照国际厂商同类加速卡的 150 至 350 瓦,公司称由此把机架租用数量与运营、部署成本各降约 50%(资料来源:H***公开材料,2026 年)。
1.10 关键参数与指标体系
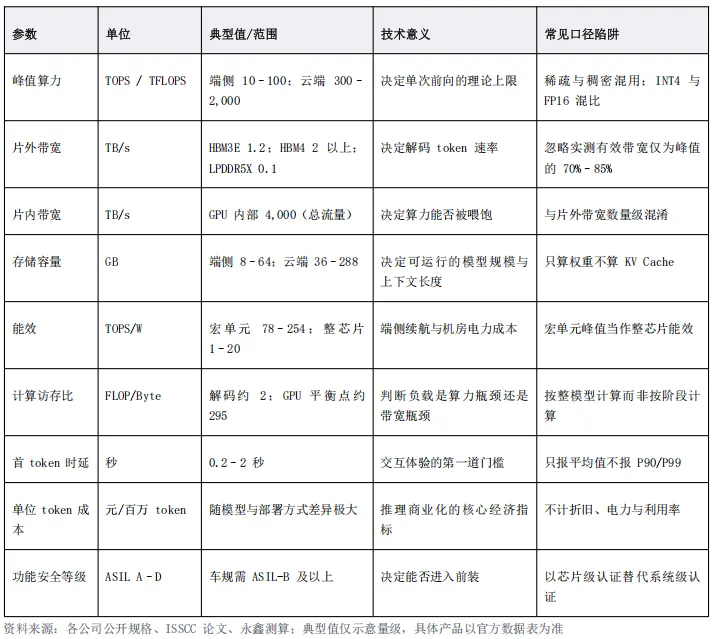
AI 芯片的参数可分五类:算力、带宽、容量、能效、互联与软件。五类参数必须成套阅读,单看任何一项都会得出错误结论。
算力:以 TOPS(整数)或 TFLOPS(浮点)计,须注明精度(FP4/FP8/INT8/INT4)与是否稀疏。标称峰值通常是稀疏峰值,实际持续算力受功耗与带宽约束,差距可达 3 至 5 倍。
带宽:以 TB/s 或 GB/s 计,分片外(HBM/LPDDR)与片内(交叉开关、NoC)两层。解码性能由片外带宽决定,多卡扩展效率由片间互联决定。
容量:以GB 计,须区分权重容量与 KV Cache 容量。长上下文场景中 KV Cache 会超过权重,成为新的容量瓶颈。
能效:以 TOPS/W 计,端侧是首要指标。须区分宏单元能效与整芯片能效,前者常被用作宣传口径。
互联与软件:片间互联带宽(NVLink、UCIe、PB Link)、集群规模、编程模型与算子库覆盖度,决定实际可用算力的比例。
2. AI芯片市场分析
2.1 市场空间驱动因素
本行业的需求方有四类:云服务商与大模型公司(训练与推理集群)、终端厂商(手机、PC、可穿戴)、整车厂与 Tier1(座舱与智驾)、行业客户(安防、工业、机器人)。四类客户的采购逻辑不同,前者买算力密度与生态,后者买能效、成本与可交付性。
核心驱动因素包括:
1.推理需求接棒训练。训练与推理的算力占比正从当前的 6:4 转向 2027 年的 3:7,推理芯片的单位经济性取代峰值算力成为采购首要标准(资料来源:Gartner,转引自公开报道)。
2.Agent 化抬升请求密度。智能体普及使单用户日均推理请求从 2025 年的约 10 次增至 2026 年的约 50 次,调用量同比增长 300% 以上(资料来源:中国电子报,2026 年 3 月)。
3.端侧从可选变标配。2026 年 AI 手机渗透率约 45%,AI PC 约 31%,旗舰手机 NPU 峰值算力达 100 TOPS;端侧算力占比首次超过云端,达 52.3%(资料来源:三个皮匠报告汇编,2026)。
4.存储成为价值核心与约束。HBM 占 DRAM 产值近四成,产能缺口 50% 至 60%;单台 AI 服务器的 DRAM 用量为传统服务器的 8 倍、NAND 为 3 倍(资料来源:SEMI、中国电子报)。
5.国产替代进入放量期。2026 年国产 AI 加速卡出货预计 215 万至 240 万张,同比接近翻倍;国产自给率由 2025 年的约 35% 升至 2026 年的约 45%(资料来源:雪球行业分析、三个皮匠报告汇编)。
6.模型架构变化创造新硬件位。MoE 与长上下文使 KV Cache 成为独立瓶颈,催生 HBF、KV Cache 卸载、PD 分离等新形态。
7.单位 token 成本成为竞争指标。按行业通行口径,用户感知的是完成任务的总成本,构成为“单任务成本 = 单任务 token 量 × 单位 token 成本”:单位 token 成本下降会释放更多场景,反过来推高 token 总量,形成正循环。同一口径提出推理在市场中的占比将从 55% 升至 80%,高于 Omdia 口径的 60.1%(2030 年),两组口径起点与统计边界不同,本文并列保留、不做取舍。
8.政策把存算一体列入国家级技术清单。我国“十五五”规划(2026 至 2030 年)专栏 3 明确“推进存算一体、三维集成、光电融合等技术突破应用”;国家发展改革委自 2024 年起将存算一体作为变革性技术提档支持,2024 年 11 月与 2025 年 4 月先后发布“面向 AI PC 大模型推理需求的存算一体芯片研发及产业化”与“端侧新型存储介质存算一体推理芯片”两期揭榜挂帅项目,2025 年 6 月H*** M50 入围工业和信息化部算力强基揭榜行动(资料来源:H***公开材料汇编的政策文件,2026 年)。
9.智能体常态化把推理推向本地。按 IDC 口径,全球活跃智能体数量由 2025 年约 2,860 万增至 2030 年约 22.2 亿,复合增速 139%(永鑫按端点复算为 138.8%);按单任务 1 万 token、日均 50 次任务、5 个并发智能体估算,日消耗约 250 万 token,按公有云 API 计价月账单落在 4,000 至 2 万元区间,本地部署的经济性随之凸显。H***据此提出“端边侧算力结构将复刻云端剧本”:云端在 2019 年前后为通用计算占八成、AI 占两成,2025 年已反转为 AI 占八成;端边侧预计由 2026 年的通用计算八成转为 2032 年的 AI 八成(资料来源:H***公开材料,2026 年)。
关键测算锚点:每台 AI 手机约 30 至 50 美元的 AI 芯片价值量,每台 AI PC 约 80 至 100 美元,单车智驾与座舱合计约 300 至 600 美元。这三个锚点构成 2.3 节自下而上测算的基础。
分析框架上,本文采用两条路径交叉:自上而下用第三方机构的端侧与云侧总量数据做趋势约束;自下而上用“终端出货量 × 渗透率 × 单机价值量”重算,两者偏差写入正文而非静默取舍。
2.2 供给端:制程、存储与封装的三重约束
AI 芯片的供给不取决于设计能力,而取决于三个物理环节:先进制程产能、高带宽存储供给、先进封装产能。三者在 2026 年均处于紧平衡。
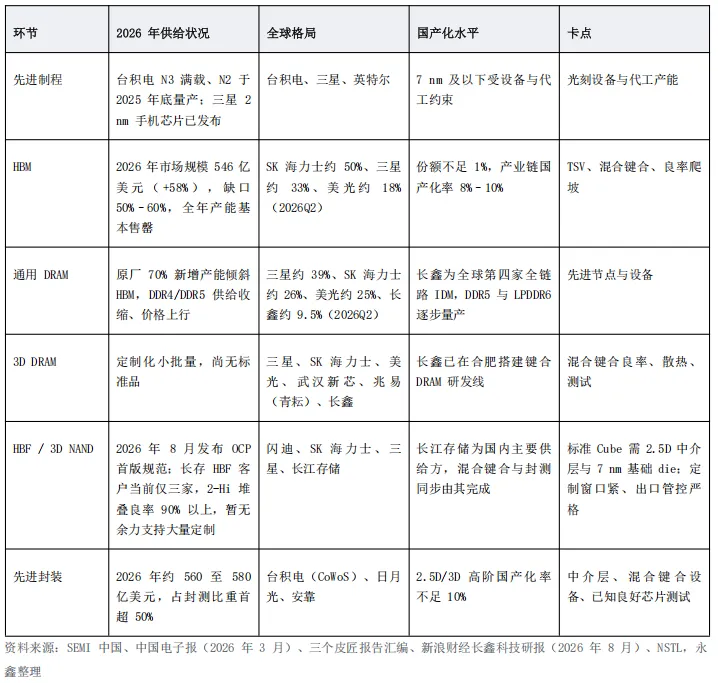
这三重约束共同塑造了国产 AI 芯片的现实路径。既然拿不到最先进制程与足量 HBM,就只能在“架构换制程、封装换带宽、介质换成本”上做文章:用 22 至 28 nm 的逻辑片叠上定制 3D DRAM,以混合键合替代 CoWoS,用 SRAM 或 ReRAM 替代部分 DRAM 访问。这一路径不是权宜之计,而是被供给条件逼出的技术选择,也解释了为什么近存与存算在国内的产业化节奏快于海外。
一个具体的产业信号是:高通与兆易创新合作开发面向手机的独立 NPU,搭配长鑫制造的 4 GB 定制 3D DRAM,算力约 40 TOPS,采用 TSV 与混合键合堆叠,预计 2026 年底至 2027 年初出货,目标 4,000 至 4,500 元以上机型(资料来源:天风国际郭明錤,转引自 ITnews、半导纵横,2026 年 4 月)。这意味着“独立 NPU + 3D DRAM”从创业公司的方案变成了主芯片大厂的路线。2.3 市场空间测算
测算前须先解决口径问题。AI 芯片的市场规模在不同机构间相差近六倍,原因不是谁算错了,而是统计边界不同。下表并列四家机构的公开口径,不可加总,也不可直接比较。
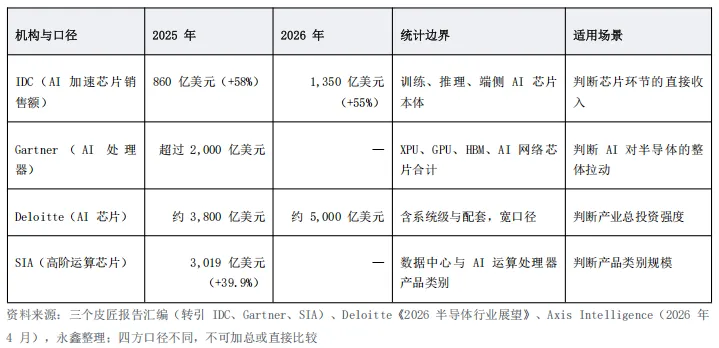
比总量更有意义的是训练与推理的结构拆分。按 Omdia 口径,全球 AI 芯片市场 2025 年 600 亿美元、2030 年 1,830 亿美元,其中推理芯片由 270 亿美元增至 1,100 亿美元,占比从 45% 升至 60.1%,复合增速 32.4%,显著高于训练芯片的 17.2%(资料来源:Omdia 报告)。这一组数字与前述“训练与推理占比由 6:4 转向 3:7”的判断方向一致,可作为结构测算的锚点。
同一结构在不同机构间分歧极大。另有券商与研究机构给出的 2030 年推理芯片口径,显著高于本文采用的 Omdia 序列(差异在两倍以上,永鑫按端点粗算)。差异可能来自三处:是否把整机与配套计入、云厂商自研芯片是否按内部结算价计价、“推理”是否包含端侧 NPU。原始报告均未在公开渠道披露,本文不据此调整结构测算,仍以 Omdia 序列为主。
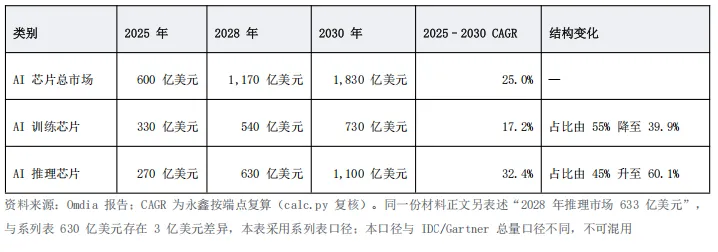
本文聚焦可核验的端侧与国产两个细分,采用自下而上重算。假设条件全部显式列出,缺失项不强行填补。
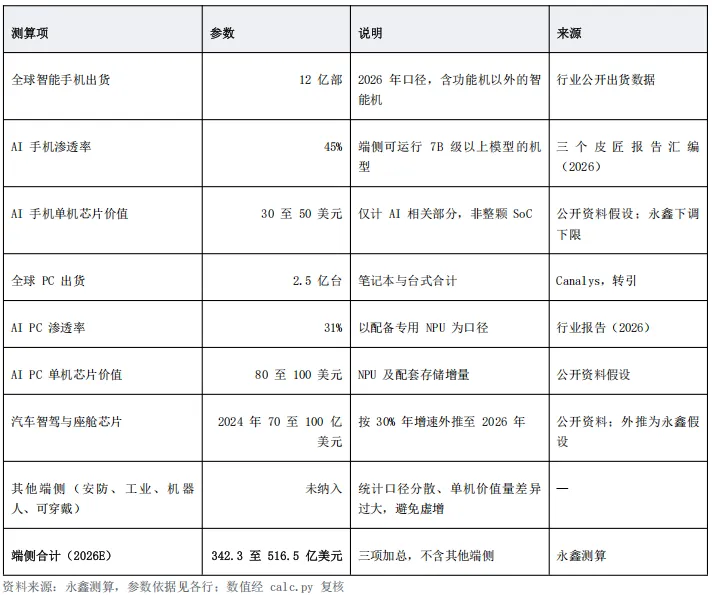
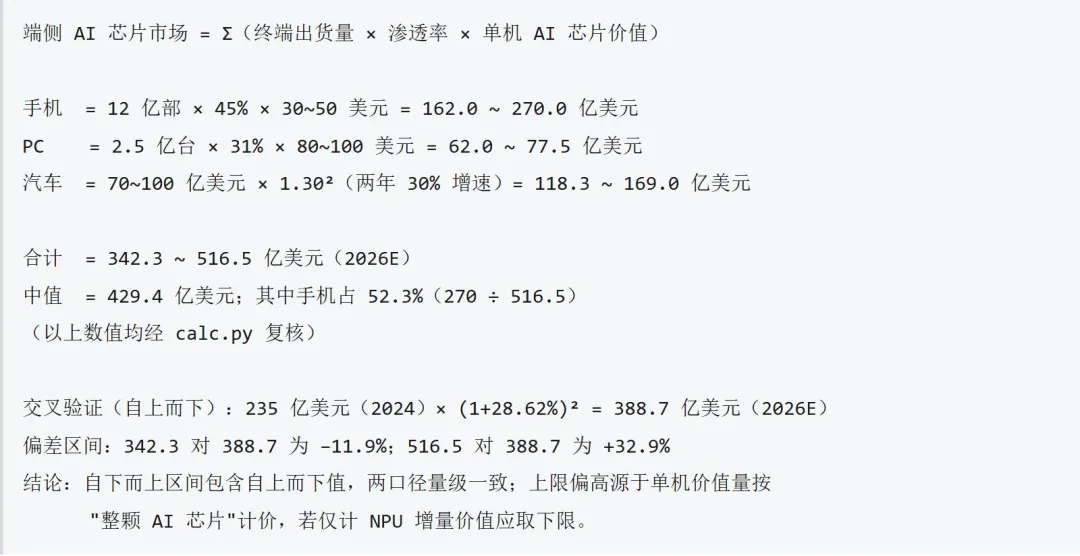
关键假设:(1)AI 手机渗透率 45%、AI PC 31% 取行业报告中值,若终端出货下行 10%,合计下调约 10%;(2)单机价值量为“AI 相关增量”,非整颗 SoC 价格,手机取下限更接近真实采购口径;(3)汽车板块以 2024 年 70 至 100 亿美元为基数、按年增 30% 外推两年,该增速为永鑫假设,未经原始报告验证;(4)其他端侧未纳入,实际市场应高于本测算下限。
交叉校验与敏感性:H***公开材料转引 Counterpoint 口径给出 2026 年全球智能手机销量约 11 亿部、AI 手机渗透率 45%,全球 PC 销量 2.5 亿台,联想 2025 年 AI PC 渗透率已超过 30%(资料来源:H***公开材料,2026 年)。其中两项渗透率与本文假设一致,手机出货口径则比本文采用的 12 亿部低约 8%。若改按 11 亿部重算,手机项为 148.5 至 247.5 亿美元,端侧合计变为 328.8 至 494.0 亿美元(永鑫复算,数值经 calc.py 复核),仍包含自上而下值 388.7 亿美元——出货口径 1 亿部的差异不改变结论量级。同一材料另给出“2027 年全球 AI PC 渗透率达 85%”,明显高于本文采用的 31%;后者为 2026 年当年口径,前者为次年预测,两者不冲突但不可直接比较。
本测算为不完全统计,覆盖手机、PC、汽车三个板块,未纳入安防、工业、机器人与可穿戴。另有一组存算一体的市场预测可作方向参照:全球存算一体市场预计到 2030 年增至 312 亿美元(资料来源:前途科技,2026 年 8 月;原始研究机构待确认,统计范围含近存、存内处理与存内计算三类),因口径未明,本文不将其纳入加总。
还需区分终端口径:IDC 统计 2025 年全球端侧 AI 设备出货 12 亿台,ABI Research 预计 2028 年 40 亿台(资料来源:IDC、ABI Research)。此为“端侧 AI 设备”口径,含手机、PC、平板与可穿戴;与本节测算所用的“全部智能手机出货 12 亿部”不是同一指标,两者数字巧合相同但不可互换——若误用会同时高估手机基数与渗透率。
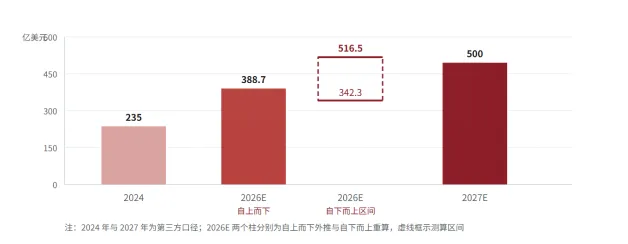
云侧另有量级。数据中心 AI 加速器 2026 年规模约 800 亿美元,占 AI 芯片总量约六成(资料来源:Gartner 预测,转引自 AI Trends HUB);英伟达 2026 财年数据中心收入 1,935 亿美元、同比增长 68%,2027 财年第一季度单季 752 亿美元、同比增长 92%(资料来源:英伟达财报,转引自 Axis Intelligence)。
国产一侧可用出货量交叉验证:2026 年国产 AI 加速卡出货 215 万至 240 万张,按单卡均价 5 万元估算,对应约 1,075 至 1,200 亿元,取中值约 1,500 亿元量级的上限情形(300 万张 × 5 万元)折合约 211 亿美元,与中国 AI 芯片市场 2024 年 1,425 亿元、占全球 25% 至 30% 的公开口径方向一致(资料来源:弗若斯特沙利文,转引自公开研报;单卡均价为永鑫假设)。
2.4 竞争格局:全球玩家
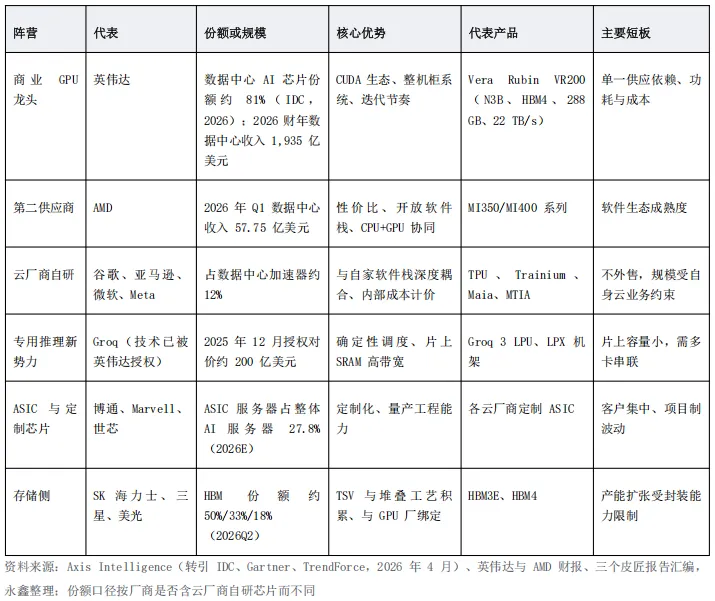
全球 AI 芯片市场是“一家独大 + 云厂商自研 + 专用推理新势力”的三层结构。英伟达在商业加速卡市场保持绝对份额,云厂商的自研芯片在内部 workload 中持续替代,而专用推理芯片在 2026 年因英伟达自身的整合动作被正式确认为一条独立赛道。
2.5 竞争格局:国内玩家
国内已形成“一超多强”格局。2026 年华为昇腾交付预计约 130 万张,超过其他国产厂商总和;阿里平头哥约 40 万张;百度昆仑芯、寒武纪、海光各约 20 万张;沐曦、壁仞、摩尔线程、天数智芯合计 25 万至 30 万张(资料来源:国海证券刘熹、太平洋科技,2026 年)。总量口径存在分歧:215 万至 240 万张(雪球行业分析)与 300 万至 400 万张(国海证券)并存,差异来自是否计入推理卡与白牌产品,本文并列保留。
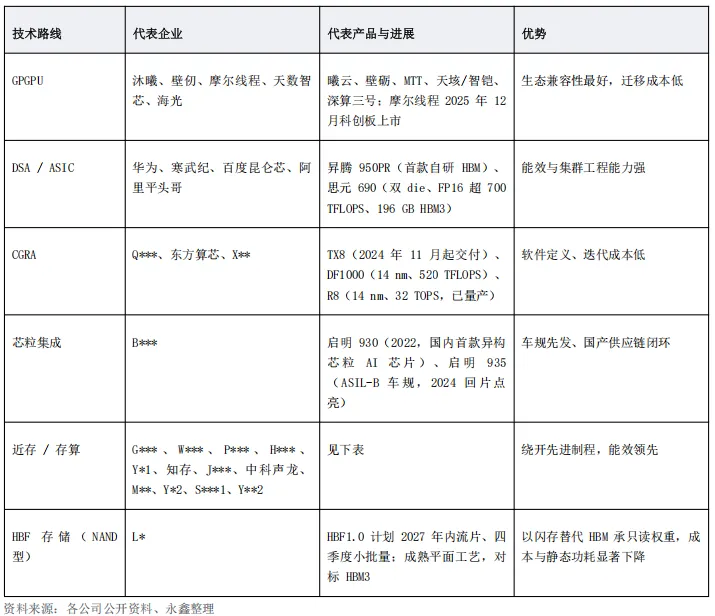
近存、存算与非冯架构这一支是国内创业最密集、路线分歧最大的板块。下表按“介质 + 计算位置 + 产品阶段”分组,只列路线归属与阶段,不做逐家横向比较。
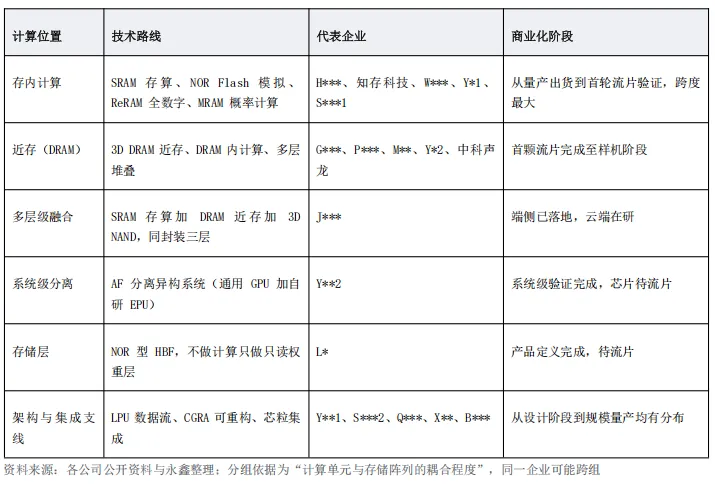
国产化能力判断:在通用 GPGPU 与云端训练上属部分替代,卡点在先进制程与 HBM;在端侧 NPU 与 AIoT 上属已可替代,国产在中低端市场已主导;在近存与存算上属并跑乃至局部领先,卡点在 DRAM 原厂协同、混合键合良率与算子生态三层,而非架构本身。系统层面另有一条独立赛道(详见 1.7 节):把容量与带宽按负载属性解耦——先是按阶段的 PD 分离,再是按算子的 AF 分离——其门槛落在互联、路由与软件栈,而非单颗芯片的性能,国内创业公司在这一层同样有可参与性,代价是要接受“只服务特定速率区间”的场景限制。
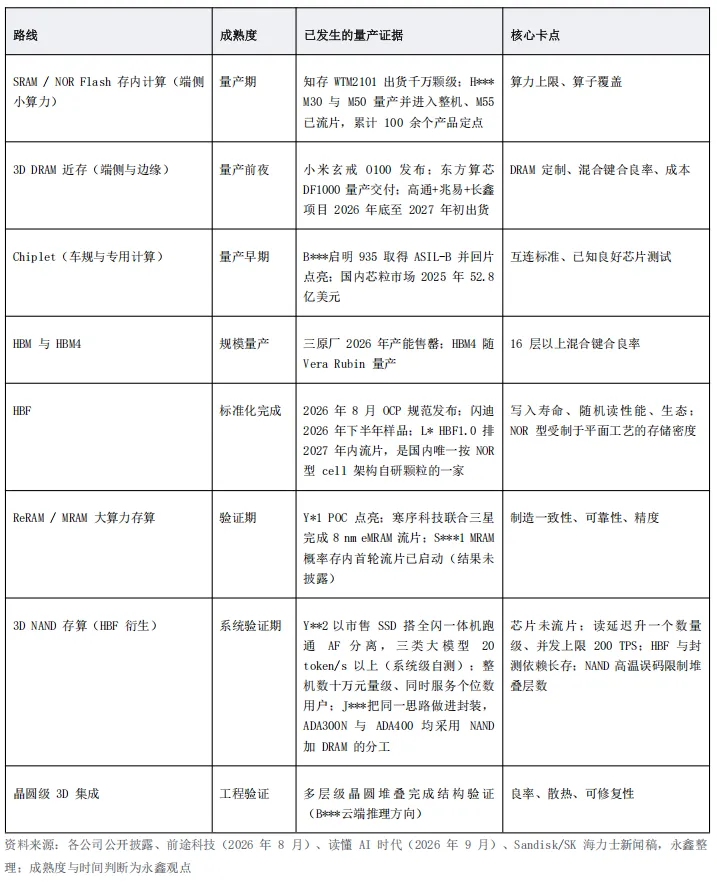
2.6 技术路线的商业化进度排序
把各条路线的“技术成熟度”与“商业落地证据”并列,可以排出一条相对清晰的时间轴。排序依据只有两条:是否有量产出货,是否有客户复购。
3. 永鑫观点
AI 芯片的竞争焦点已经转移。2023 年至 2025 年比的是峰值算力与制程节点,2026 年之后比的是“数据离计算多远”与“负载拆给谁”。这一转向对国产有利:架构与封装重排依赖工程能力,而非设备获取。
赛道需分层定价。云侧训练仍是 GPU 加 HBM 的天下,国产替代由政策与供应链驱动,确定性高但毛利被压薄;真正的增量集中在三处——云侧解码专用化(PD 分离后的带宽型芯片)、端侧独立 NPU 加大容量近存、车规芯粒。存内计算在小算力场景已闭环,但宏单元能效换算成整芯片竞争力仍有距离。
2026 至 2028 年是近存与存算从样机走向量产的窗口期,胜负由工程兑现速度决定,而非峰值指标;一级市场可以把“是否已进入客户机型”作为比“算力数字”更前置的筛选条件。
永鑫持续关注相关赛道发展,赋能AI芯片公司。
参考资料
1.Gartner.《AI Chip Market Share 2026: Vendor Revenue, ACDI Index, Hyperscaler Capex》,转引自 Axis Intelligence:https://axis-intelligence.com/ai-chip-market-share/
2.三个皮匠报告.《全球 AI 芯片市场规模(IDC / Gartner / SIA 口径汇编)》:https://www.sgpjbg.com.cn/searchtag/27140943.html
3.Deloitte.《2026 半导体行业展望》,转引自:http://www.twtip.com?p=1538/
4.中国电子报.《AI 开新元,共铸半导体万亿美元时代》,2026 年 3 月:https://epaper.cena.com.cn/pc/attachment/202603/20/06cf5415-239e-44bb-a180-af1a88b46b74.pdf
5.界面新闻.《2026 年国产 AI 芯片深度观察:算力爆发、管制倒逼、生态成熟》,2026 年 9 月:https://www.jiemian.com/article/15045742.html
6.雪球.《2026 年国产算力卡与光模块全年行业分析》:https://xueqiu.com/1981131156/384287297
7.太平洋科技.《中国 AI 芯片,到底行不行?》,2026 年:https://g.pconline.com.cn/zhizao/article/1661067.html
8.Sandisk & SK hynix.《Sandisk and SK hynix Advance Global Standardization of High Bandwidth Flash》,2026 年 8 月 3 日:https://www.sandisk.com/company/newsroom/press-releases/2026/2026-08-03-Sandisk-and-sk-hynix-advance-global-standardization-of-hbf
9.SK 海力士新闻室.《SK 海力士与闪迪发布 HBF 首个标准规范》,2026 年 8 月 4 日:https://news.skhynix.com/cn/hbf-at-fms-2026
10.NSTL 重点领域信息门户.《高带宽闪存(HBF)首个标准规范发布》,2026 年 8 月
11.半导纵横.《HBF 火爆,背后的机会有多大?》:https://www.icviews.cn/news/36531/7
12.前途科技.《存算一体进入量产交付期:小米玄戒 O100、东方算芯 DF1000、谦合益邦密集落子》,2026 年 8 月:https://accesspath.com/compute-chips/processing-in-memory-china-chips-xiaomi-dongfang-qianhe-2026
13.读懂 AI 时代.《存算一体进入产业化时刻,多款芯片量产交付》,2026 年 9 月:https://www.readaitime.com/zh-hant/news/2026-09-01/2d64zlld
14.靳若琦.《存算一体(CIM/PIM)技术现状调研报告》,2026 年 6 月
15.腾讯新闻.《AI 芯片:回望过去一年,展望 2026》,2026 年 3 月:https://view.inews.qq.com/a/20260324A02UUW00
16.百度百科.《Groq》《Groq LPU》词条:https://baike.baidu.com/item/Groq/62906999
17.Inside Deep Tech.《Groq: The Speed King of AI Inference and the Startup Nvidia Couldn't Ignore》:https://www.insidedeeptech.com/groq-review
18.Utilix.《Nvidia's $20 Billion Groq Deal: How a Reverse Acquihire Buys Chip Talent》:https://www.utilix.tech/blog/nvidia-groq-20-billion-deal-reverse-acquihire
19.ServerGurus.《Disaggregated Inference: Why Splitting Prefill and Decode Is the 2026 Architecture》:https://www.servergurus.com/blog/disaggregated-inference
20.AppScale.《KV-Cache Engineering for LLM Inference: Paged Attention, Prefix Cache, and Prefill/Decode Disaggregation》,2026 年:https://appscale.blog/blog/kv-cache-engineering-llm-inference-paged-attention-prefill-decode-disaggregation-2026
21.半导纵横.《WAIC 2026 无问芯穹:跨集群异构 PD 分离架构 PDD》:https://www.icviews.cn/news/33702/7
22.ITnews.《高通、长鑫合作细节曝光 联手打造手机独立 NPU》,2026 年 4 月:https://www.itnews.vip/2026/04/15/
23.三个皮匠报告.《集成芯片与芯粒(Chiplet 市场规模与标准汇编)》:https://www.sgpjbg.com/searchtag/27133197.html
24.贸易与全球市场联盟(UTW).《全球及中国 Chiplet 芯粒互联行业发展及市场前景洞察报告》,2026 年:https://www.utw.net.cn/2191/view-518780-1.html
25.三个皮匠报告.《存储芯片投研报告(HBM 与 DRAM 份额汇编)》:https://www.sgpjbg.com/searchtag/26351197.html
26.新浪财经.《长鑫科技(688825):中报超预期,DDR5 占比提升,LPDDR6 将率先量产》,2026 年 8 月
27.车乾信息.《端侧芯片:AI 普及浪潮里的算力底座》(微信公众号)
28.三个皮匠报告.《端侧 AI 发展情况(手机 NPU 与 SoC 份额汇编)》:https://www.sgpjbg.com.cn/searchtag/26735621.html
29.Vaswani 等.《Attention Is All You Need》,2017 年:https://arxiv.org/abs/1706.03762
30.Shazeer 等.《Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer》,2017 年:https://arxiv.org/abs/1701.06538
31.澜起科技.《澜起科技业界试产 CXL 3.2 内存扩展控制器》,2026 年 7 月 31 日:https://www.montage-tech.com/tc/Press_Releases/20260731
32.澜起科技.《破解推理内存墙:为何 MRDIMM 与 CXL MXC 是稀疏 AI 时代的理想选择》,2026 年 10 月:https://www.montage-tech.com/tc/Blog_posts/20261019
33.中国日报网.《曦智科技:让光电混合算力从技术优势转化为可规模交付的产业胜势》,2026 年 8 月 27 日:https://cnews.chinadaily.com.cn/a/202608/27/WS6a8fe1dde4b09a165c78661a.html
34.腾讯新闻.《直击 WAIC 2026:曦智科技定义 AI 算力三次方时代》,2026 年 7 月 19 日:https://news.qq.com/rain/a/20260719A04SUT00